
AI에게 받은 응답이나 문서를 두 번, 세 번 읽은 적이 있을 것이다. 틀린 말은 없는데 그래서 무엇을 하자는 건지가 잡히지 않는다. 결국 “그래서 뭘 하라는 거야?”를 한 번 더 묻게 된다. 나는 이 되묻기를 줄이려고 Claude Code(클로드 코드)의 문체 규칙을 다섯 달 동안 고쳤다. 마지막에는 항공 정비 문서의 표준인 ASD-STE100 규칙까지 가져왔다.
9월 29일 밤에도 그랬다. 그날 Claude Code에서 받은 응답은 무엇을 하겠다는 건지 읽히지 않았다. 그래서 이렇게 보냈다.
어떻게 하겠다는 건지 잘 이해가 안되 사람이 이해하기 쉽게 하는 부분이 필요할 것 같아 전역적으로 개선해줘
지금은 응답이 결론으로 시작하고 이유가 앞 문장에서 이어지며 할 일로 끝난다. 거기까지 네 가지 방법을 차례로 거쳤다.
- 뺀 일. AI 응답을 받고 "그래서 뭘 하라는 거야?"를 되묻는 일. 생성한 문서를 다시 풀어 달라고 하는 일.
- 남긴 일. 읽다 막힌 문장을 골라 보내는 일. 무엇을 고칠지는 아직 내가 정한다.
- 되찾은 시간. 미측정. 되물은 횟수를 따로 세지 않았다.
- 든 비용. 87줄짜리 문체 규칙 하나와 그 사본 세 개. 쓰던 Claude 구독 안에서 돌고 humanizer는 무료 오픈소스다.
처음엔 humanizer에게 문장 손질을 맡겼다
처음에는 번역투나 빈 수식어 같은 AI 티 때문에 읽기 어렵다고 봤다. 그래서 5월 말에 humanizer 스킬을 들였다. humanizer는 AI가 쓴 글에 자주 나오는 표현을 찾아 사람이 쓴 문장으로 고친다. 한국어 문서에는 한국어판인 humanize-korean을 썼다. 그 뒤로 Claude Code가 생성한 문서는 저장하기 전에 꼭 humanizer를 거치게 했다.
7월에 업무용 전략 문서를 받았을 때도 같은 방법을 썼다. 처음 보낸 말은 “전체적으로 내용이 너무 이해가 어려워 AI가 쓴것같다는거야 humanize 스킬을활용해서 업데이트해”였다. 그런데 humanizer를 거친 문서도 여전히 읽히지 않았다. 그래서 20여 분 뒤에 다시 이렇게 보냈다.
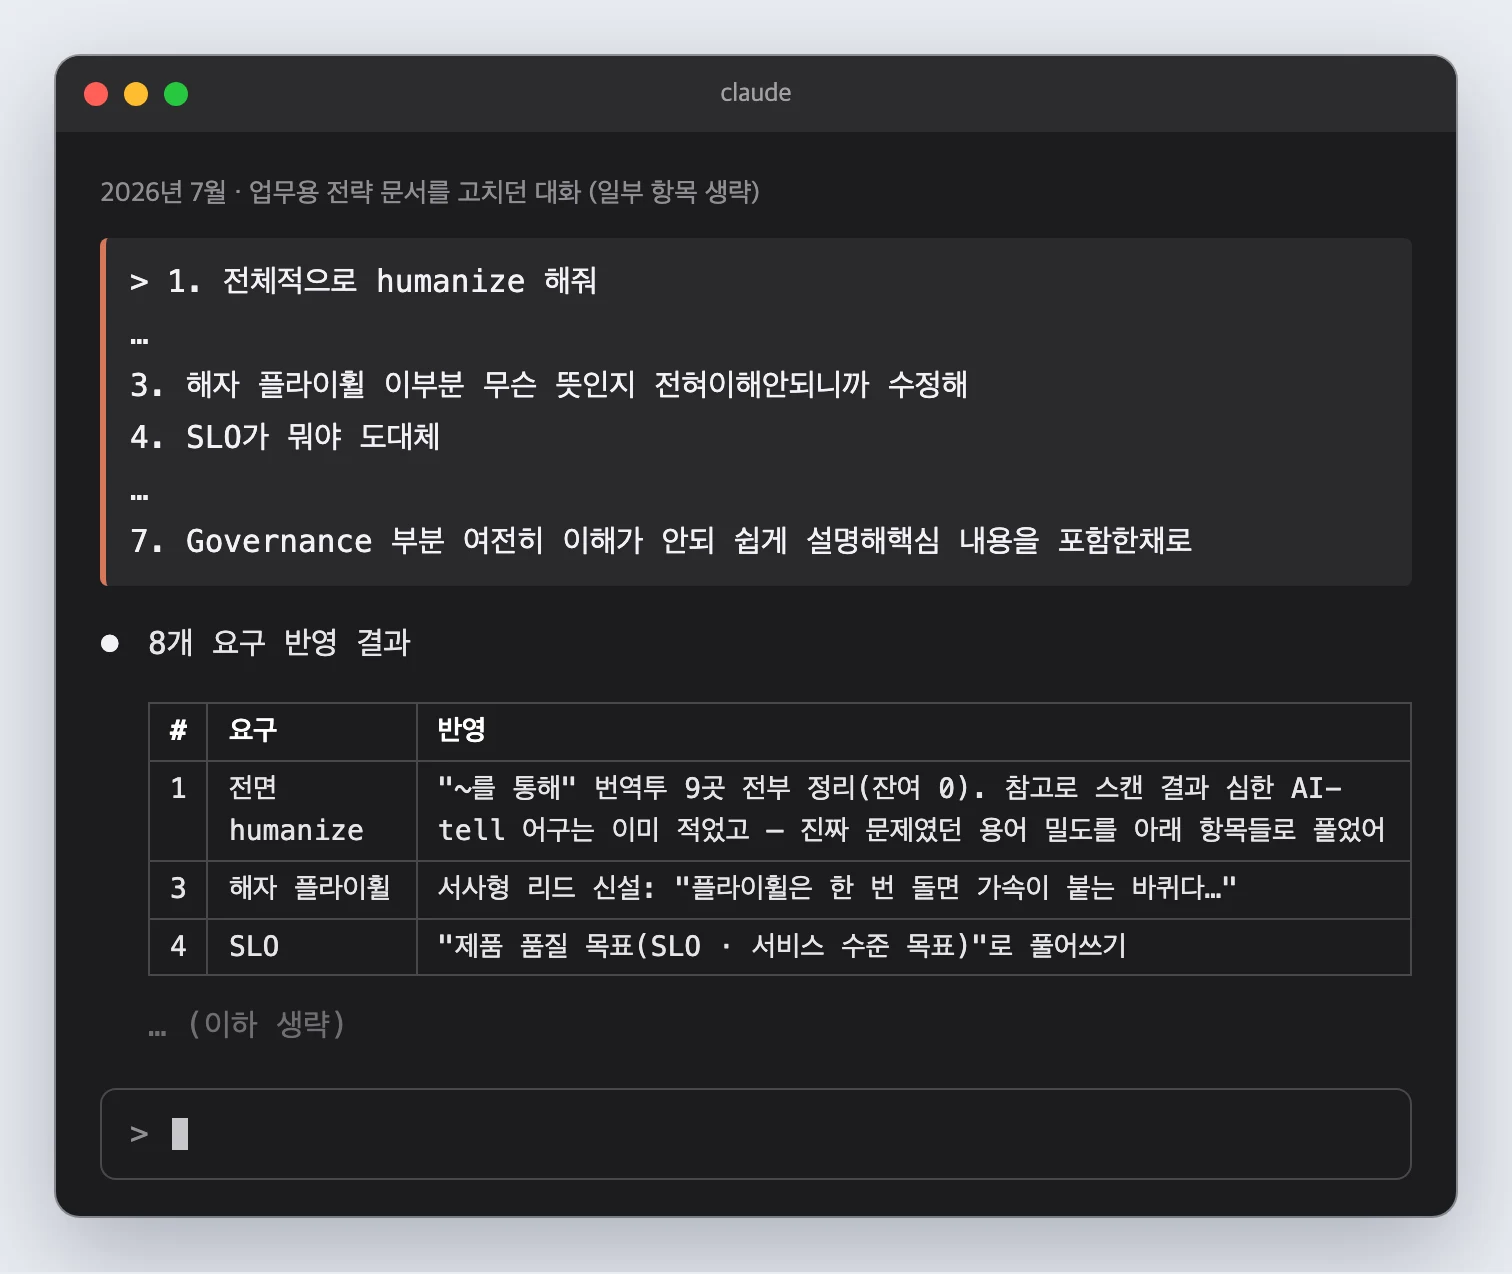
Claude는 번역투 “~를 통해” 9곳을 모두 고쳤다고 답했다. 그런데 같은 응답에 원인도 적혀 있었다. 스캔해 보니 AI 티 나는 표현은 원래 적었고 진짜 문제는 용어 밀도라고 했다. 돌아보면 이 응답이 humanizer의 한계를 먼저 보여 줬다. humanizer는 AI 티 나는 표현만 고친다. 낯선 용어가 몰린 구성이나 생각의 순서는 그대로 둔다.
문체 규칙을 다 지킨 응답은 왜 읽히지 않았을까?
8월에 만든 문체 규칙은 무엇을 빼고 얼마나 짧게 쓸지만 정했다. 문장끼리 어떻게 잇는지는 정하지 않았다. 그래서 문체 규칙을 다 지킨 응답도 사실만 늘어놓았다.
이 문체 규칙은 humanizer 다음에 고른 방법이다. 다 쓴 문서를 고치는 대신 Claude Code가 처음부터 다르게 쓰게 했다. 문체 규칙은 출력 스타일과 CLAUDE.md에 넣었다. 출력 스타일(output style)은 Claude Code가 응답할 때마다 따르는 문체 설정이다. CLAUDE.md는 Claude Code가 작업 전에 읽는 지침 파일이다.
내용은 요청을 되풀이하는 포장과 layer를 “층”으로 옮기는 억지 번역을 막는 것이었다. 그리고 응답은 결론 한 문장으로 시작하고 한 문장은 60자를 넘기지 않게 했다.
포장은 확실히 줄었다. 그런데 60자를 지키려다 보니 사실 하나가 두세 문장으로 끊겼다. 근거도 표와 글머리표로 나뉘어 왔다.
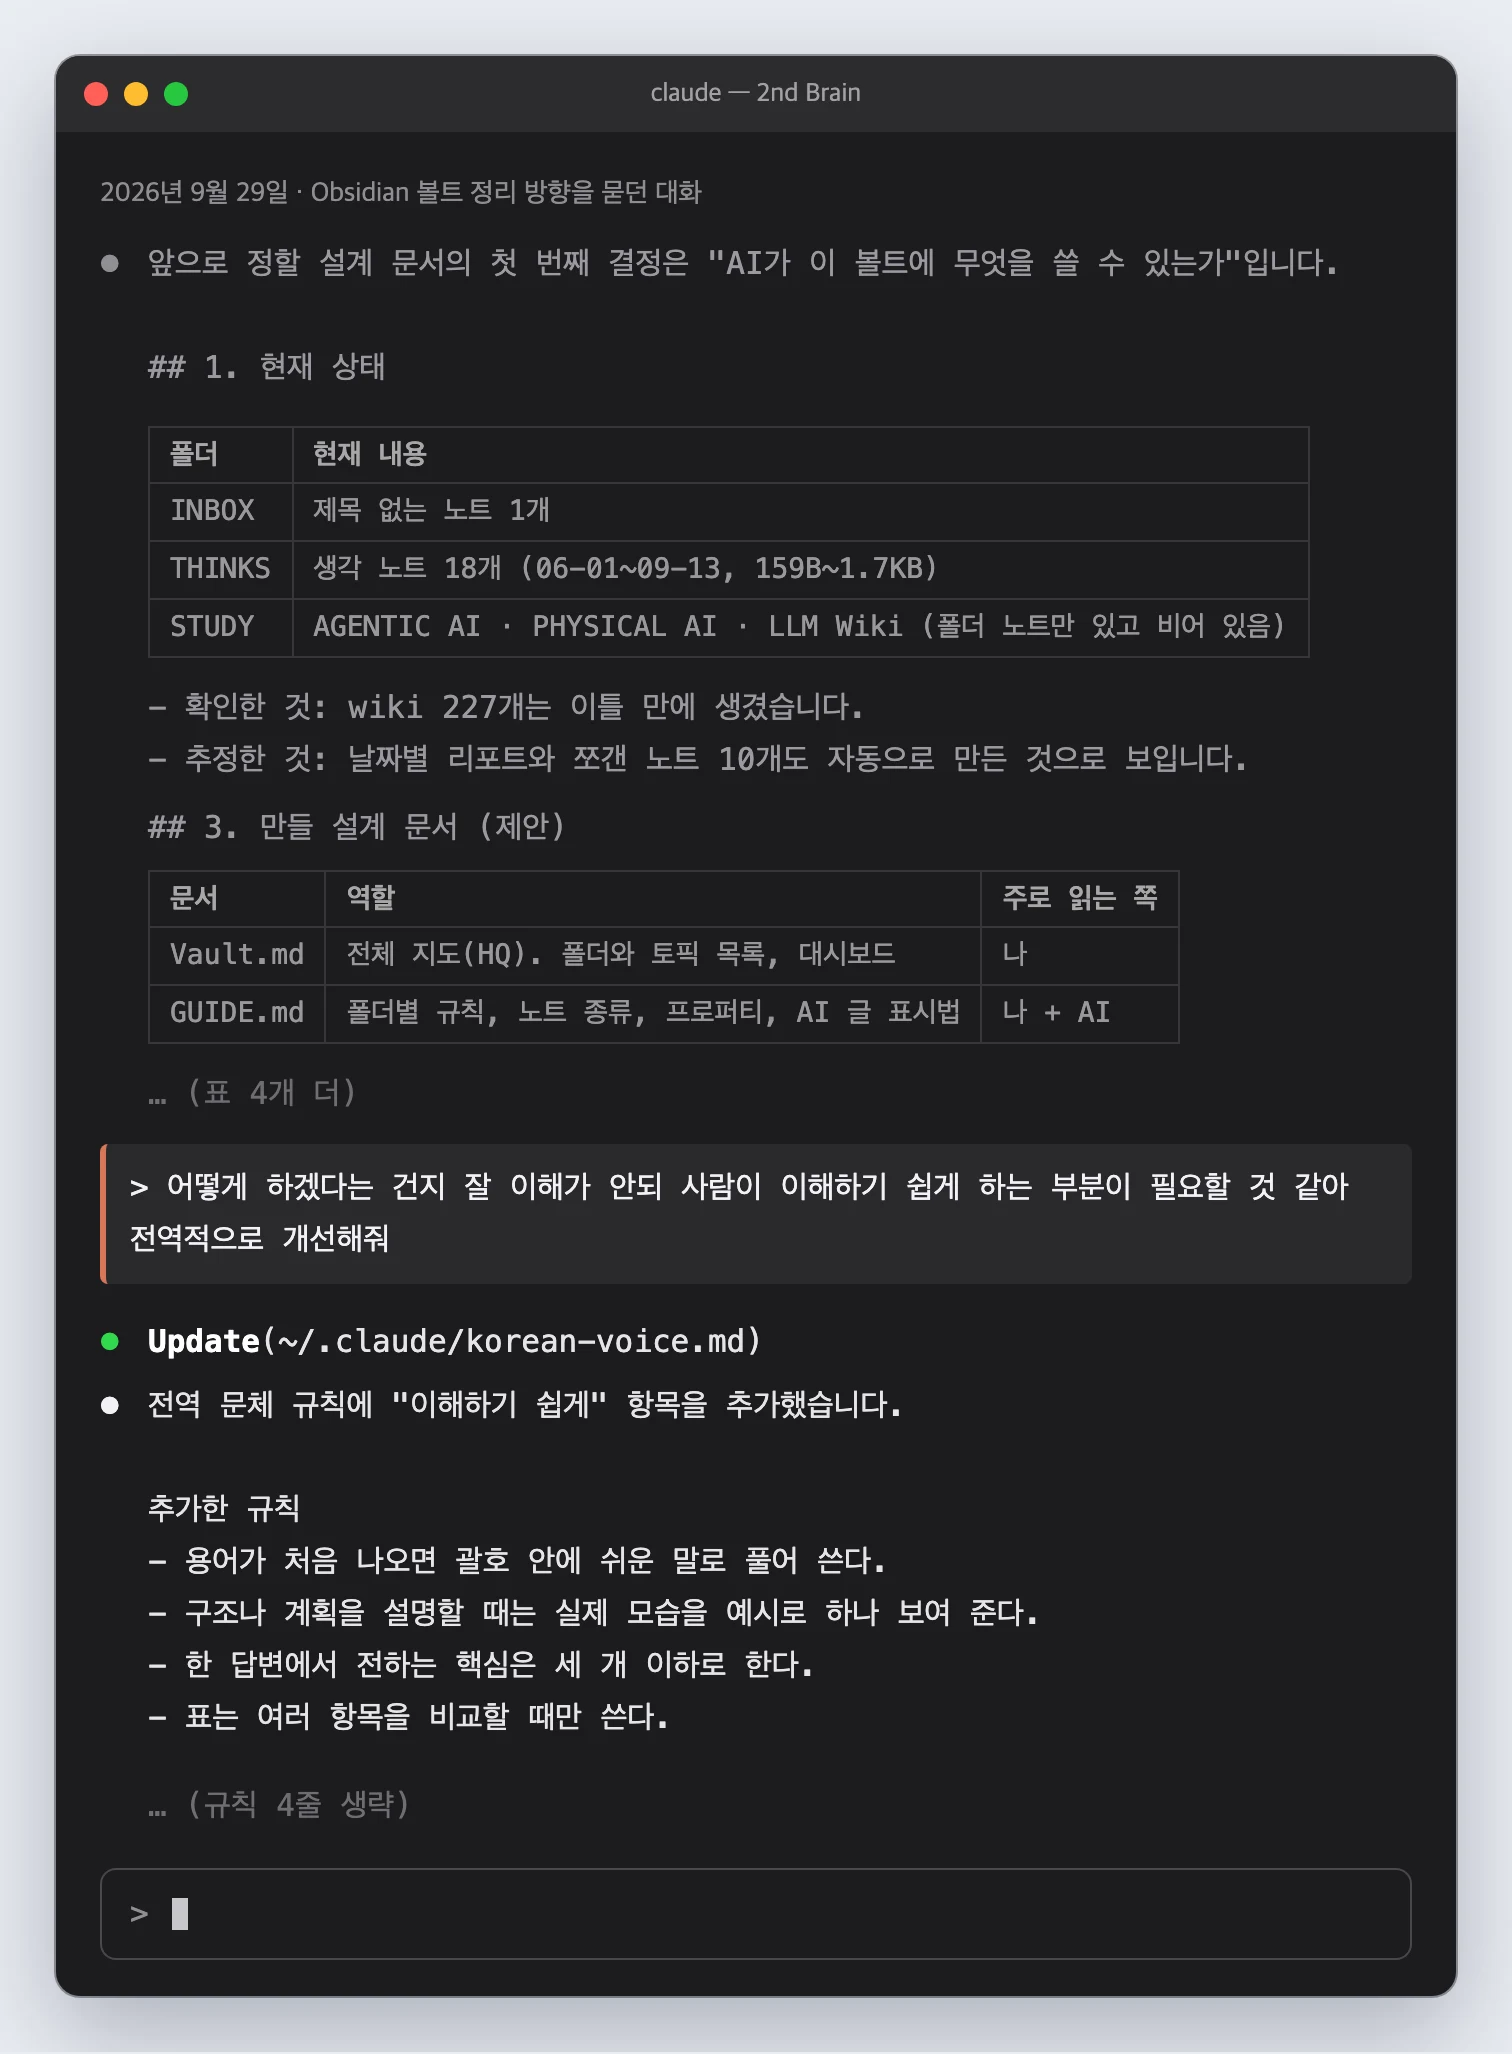
9월 29일에 받은 응답이 그랬다. Obsidian(옵시디언) 볼트를 어떻게 정리할지 물었더니 표 6개와 소제목 7개가 왔다. 글머리표도 42줄이었다. 문체 규칙을 어긴 곳은 없었는데도 무엇을 하겠다는 건지는 읽히지 않았다. 그래서 그 응답 아래에 문체 규칙 전체를 고쳐 달라고 보냈다.
“이해하기 쉽게”가 아니라 “사람의 논리”였다
Claude의 첫 처방은 응답을 쉽게 풀어 쓰는 쪽이었다. 용어를 괄호로 풀고 핵심을 세 개 이하로 줄이는 규칙 여덟 줄을 넣었다. 그런데 내가 바란 건 쉬운 말이 아니었다. 쉬운 말이 필요했다면 ELI5 스킬처럼 이미 쓸 방법이 있었다. 그래서 바로 한 줄을 더 보냈다.
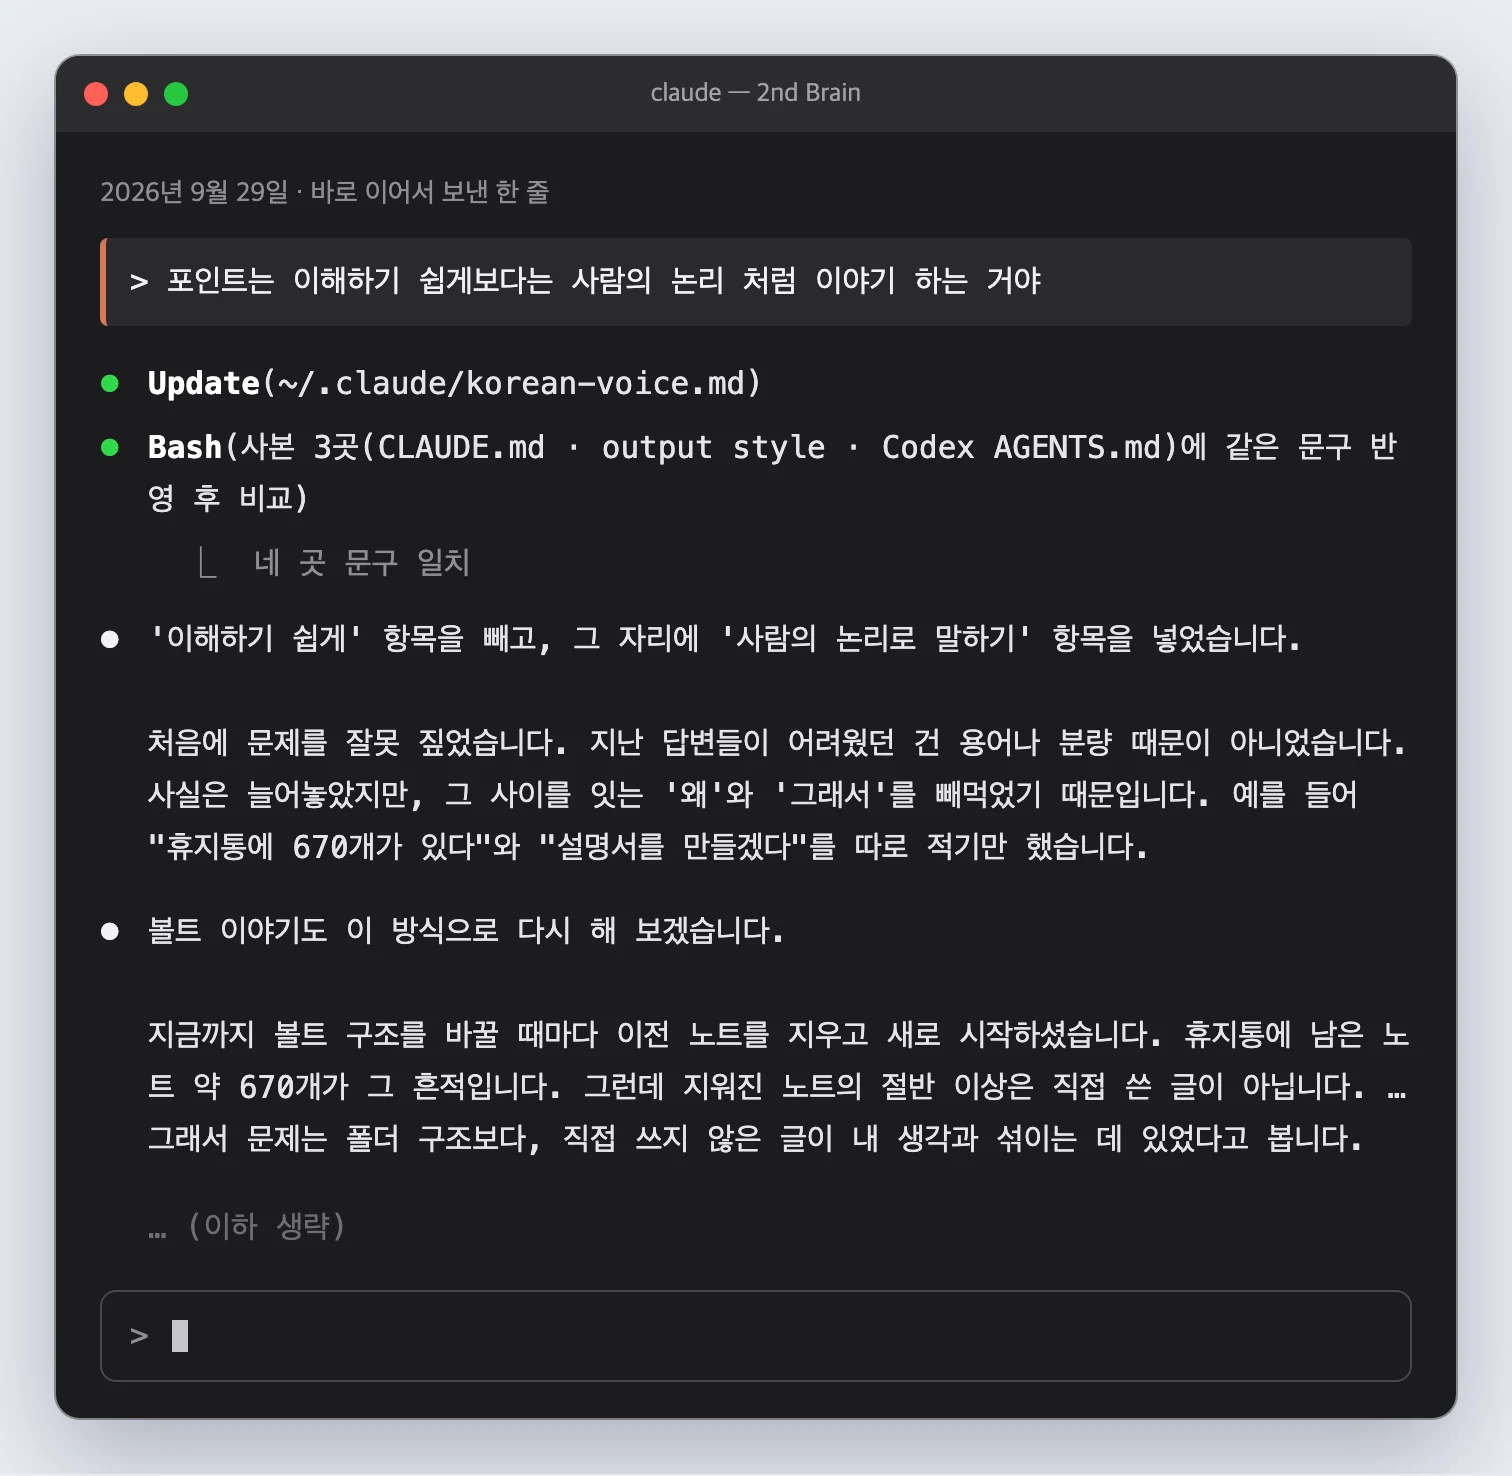
Claude는 진단부터 다시 했다. 지난 응답들이 사실은 늘어놓았지만, 그 사이를 잇는 “왜”와 “그래서”를 빼먹었다고 했다. 예를 들어 “휴지통에 노트가 670개 있다”와 “설명서를 만들겠다”를 따로 적기만 했다. 둘이 어떻게 이어지는지 말하지 않으니 무엇을 하려는지 짐작하기 어려웠다.
그래서 문체 규칙에 사람의 논리를 넣었다. 응답은 지금 상황, 무엇이 문제인지, 왜 그런지, 그래서 무엇을 하는지 순서로 이어서 말한다. 문장 사이는 “그래서”, “그런데” 같은 이어 주는 말로 잇는다. 이유가 이어지는 설명은 글머리표나 표로 쪼개지 않는다.
대화 응답은 그날 바로 달라졌다. 그런데 매일 아침 자동으로 생성되는 문서는 그대로였다. 다음 날 아침 문서는 본문 여덟 문단에 이어 주는 말이 하나뿐이었다.
이 문서는 저장하기 전에 자동 검사를 거친다. 그런데 그 검사는 흐름을 세지 않았다. 그러니 모델도 검사가 세는 항목만 맞췄다. 문체 규칙을 넣어도 세는 검사가 없으면, 자동으로 생성되는 문서에는 반영되지 않았다. 그래서 문단 두 개마다 이어 주는 말이 하나 이상인지 세는 검사를 붙였다. 그 뒤로 매일 생성하는 다른 문서에도 같은 기준을 걸었다.
ASD-STE100 규칙으로 문장의 기준을 더했다
사람의 논리는 문장과 문장 사이를 잡았다. 그런데 문장 하나와 문서 전체에는 아직 기준이 없었다. “할 수도 있을 것 같다”처럼 흐린 문장이나 줄표로 길게 이어 붙인 문장은 문체 규칙 밖에 있었다.
10월 7일에는 그 빈자리에 ASD-STE100 규칙을 넣었다. ASD-STE100은 유럽 항공업계가 1983년부터 만든 기술 문서용 영어 표준이다. 원문은 ASD 공식 사이트가 관리한다.
정비 문서는 영어가 모국어가 아닌 정비사도 읽는다. 그런데 한 문장이 두 가지로 읽히면 정비 실수로 이어질 수 있다. 그래서 이 표준은 문장마다 뜻이 하나로만 읽히도록 단어와 문장의 꼴을 정해 둔다. 읽는 사람이 뜻을 해석해야 했다는 점에서 내가 받던 응답도 같은 문제였다.
최신판은 2025년 1월에 나온 Issue 9다. 위키백과를 보면 이 판에는 규칙 53개와 승인 단어 약 900개가 있다. 문장 길이도 절차 문장은 20단어, 설명 문장은 25단어로 정해 두었다.
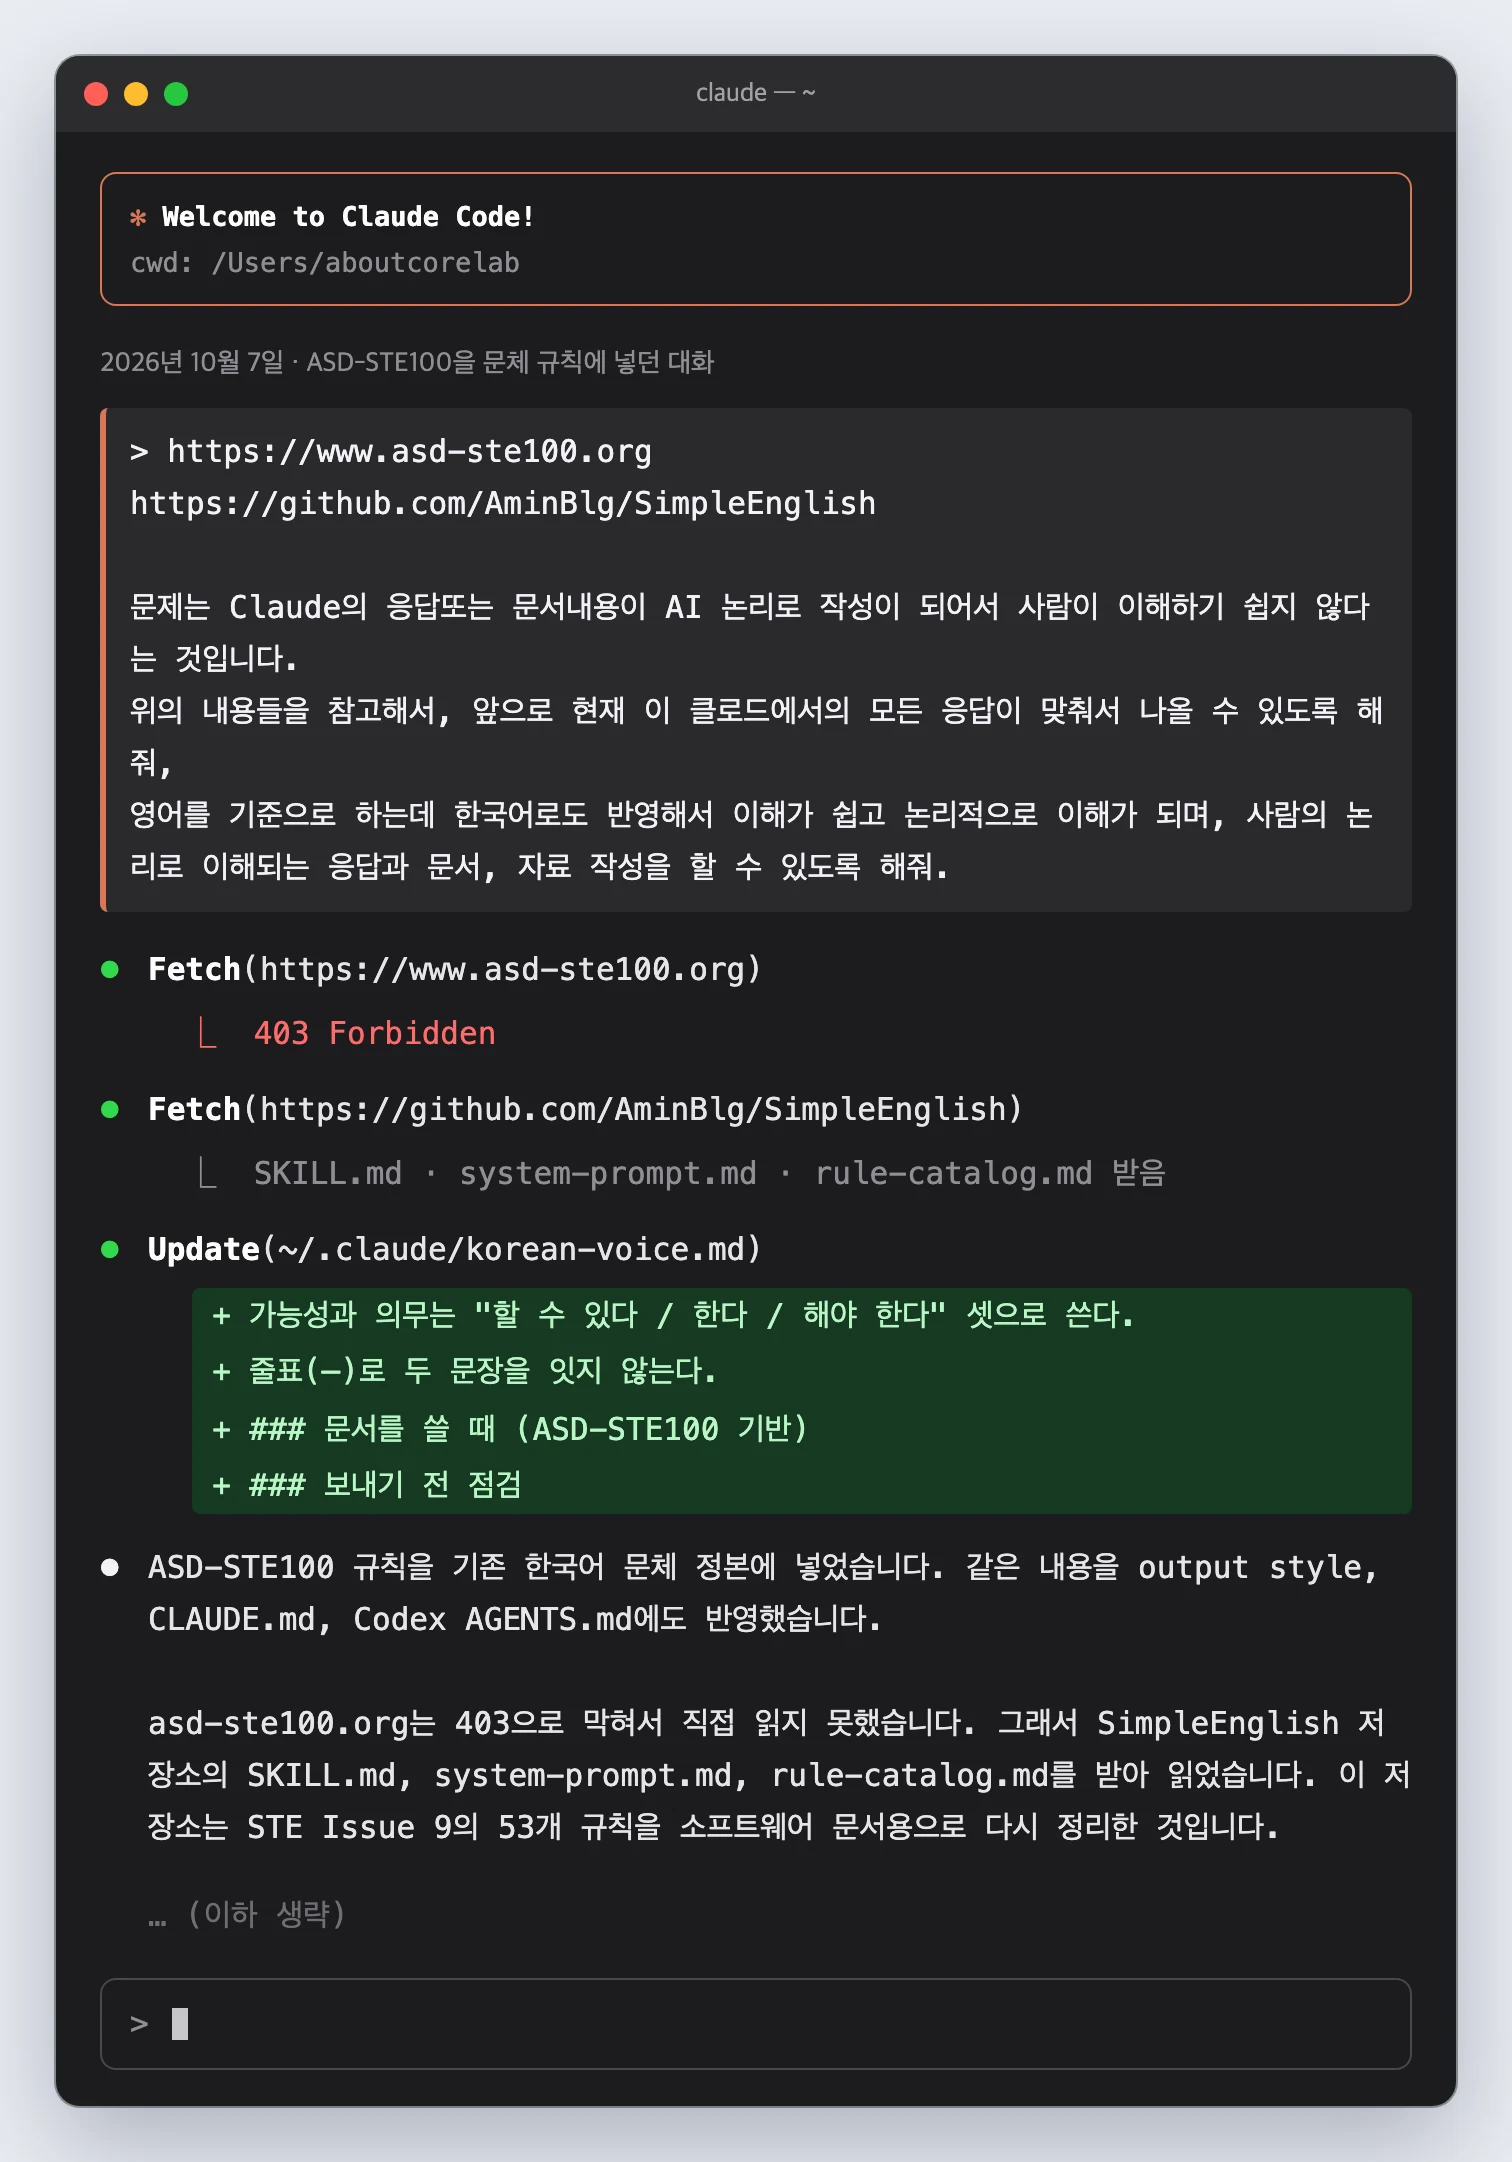
다만 이 표준은 영어 문서용이다. 그래서 한국어 응답에도 맞게 반영해 달라고 했다. 이 표준을 LLM(대규모 언어 모델)용 규칙으로 옮긴 SimpleEnglish 저장소도 함께 넘겼다. 실제로 보낸 프롬프트는 이랬다.
받아들인 ASD-STE100 규칙과 따르지 않은 규칙
Claude는 공식 사이트가 403으로 막혀 직접 읽지 못했다고 먼저 밝혔다. 그래서 SimpleEnglish에 정리된 Issue 9 규칙을 대신 읽었다. 그중 한국어에도 통하는 것만 골라 문체 규칙에 넣었다.
- 가능성과 의무는 “할 수 있다 / 한다 / 해야 한다” 셋으로만 쓴다.
- 줄표로 문장을 잇지 않고 처음 나오는 개념어는 짧게 풀어 준다.
- “핵심적인”, “~하는 것이 중요하다”처럼 중요하다고 말하지 않고 사실을 쓴다.
- 문서는 절차와 설명을 나누고 조건을 명령보다 앞에 쓴다. 한 대상은 한 이름으로만 부른다.
- 보내기 전에 가장 긴 문장 세 개를 다시 읽고 줄표와 굵은 글씨, “것 같다”를 찾아 고친다.
따르지 않은 규칙도 있다. SimpleEnglish는 대화 응답에서 목록을 모두 막는다. 그런데 ASD-STE100도 나란한 항목이 셋 이상이면 목록을 허용한다. 그래서 목록은 원래 문체 규칙대로 남겼다. SimpleEnglish 플러그인도 설치하지 않았다. 설치하면 지금 쓰는 문체 규칙이 SimpleEnglish의 것으로 바뀌기 때문이다.
humanizer와 세 번의 문체 규칙은 고친 층이 서로 다르다. 그래서 같은 질문을 해도 응답에서 바뀌는 곳이 달랐다.
● 주로 다룸 · ◐ 일부 다룸 · ○ 다루지 않음. 문체 규칙 파일과 humanizer 설명을 읽고 내가 나눈 표다.
그래서 ASD-STE100 규칙을 넣은 응답은 뭐가 달라졌나?
ASD-STE100 규칙을 넣은 응답은 소제목과 굵은 글씨 없이 이유를 이어서 말했다. 반대로 humanizer는 응답의 생김새를 전혀 바꾸지 못했다. 아래는 같은 질문을 15번 물어서 확인한 결과다.
같은 질문을 15번 물었다
같은 질문을 아래 다섯 가지 조건에서 세 번씩 물었다. 다른 설정이 섞이지 않게 개인 설정을 모두 끄고 문체 규칙만 바꿔 끼웠다.
- 문체 규칙 없음
- 문체 규칙 없음 + humanizer 윤문
- 8월 문체 규칙
- 8월 문체 규칙 + 사람의 논리
- 8월 문체 규칙 + 사람의 논리 + ASD-STE100 규칙 (지금 쓰는 문체 규칙)
실험은 Claude Code가 돌렸고 모델은 다섯 조건 모두 Opus다. 질문은 이 블로그의 실제 유입 구조를 본떠 만든 가상 상황이다.
단계마다 응답에서 바뀐 것
humanizer를 거친 응답은 소제목과 표, 글머리표 수가 원본과 같았다. 바뀐 건 “악영향”이 “나쁜 영향”이 되는 식의 단어였다. humanizer는 단어를 바꿨지만 생각을 늘어놓는 순서는 건드리지 않았다.
8월 문체 규칙은 응답을 짧게 만들었다. 그런데 근거는 여전히 표와 한 줄짜리 글머리표로 왔다. 사람의 논리를 넣자 표가 사라졌다. 이어 주는 말도 응답 하나에 평균 0.7개에서 7.7개로 늘었다.
ASD-STE100 규칙을 넣은 응답에서는 소제목과 굵은 글씨가 0개가 됐다. 또 “다만 이것은 추정입니다”처럼 추정이라고 밝히는 말이 평균 2.7개로 다섯 조건 가운데 가장 많았다. 이어 주는 말은 5.3개로 조금 줄었는데, 문장을 짧게 쓰라는 규칙과 부딪힌 결과로 추정한다.
문체 규칙 없는 응답과 ASD-STE100 규칙을 넣은 응답
실제 응답 두 개를 나란히 놓으면 차이가 더 잘 보인다. 빨간 카드가 문체 규칙 없는 응답이고, 파란 카드가 ASD-STE100 규칙을 넣은 응답이다.
1회차 응답에서 앞부분과 뒷부분을 발췌했고 문장은 고치지 않았다. 빨간 배경은 읽기를 끊는 곳이고, 노란 배경은 ASD-STE100 규칙을 넣은 응답에서 달라진 곳이다.
두 응답이 갈린 곳
두 응답의 결론은 같다. 둘 다 Threads에 글을 올리지 않은 것을 원인으로 본다. 다른 건 결론에 이르는 과정이다. 문체 규칙 없는 응답은 숫자를 표에 늘어놓고 테마의 영향은 굵은 글씨로 “최대 4명까지만”이라고 적는다. 그래서 표를 보고 판단하는 일이 읽는 사람 몫으로 남는다.
ASD-STE100 규칙을 넣은 응답은 그 판단을 문장으로 이어 간다. Threads 몫 48명이 빠지면 32명 안팎이 남아야 한다. 그런데 실제로는 45명이 왔다. 그래서 테마가 다른 방문까지 깎았다면 45명보다 낮았을 것이라고 말한다. 앞 문장에서 다음 문장이 나오니, 읽는 사람이 표를 다시 계산하지 않아도 된다.
물론 한 질문으로 세 번씩 돌린 작은 실험이다. 질문이 바뀌면 숫자도 달라진다. 그리고 이어 주는 말의 수는 흐름을 보여 주는 단서일 뿐이다. 앞 문장에서 다음 문장이 정말 나오는지는 지금도 사람이 읽어 봐야 안다.